解读:Google Cloud「代理工程 1 小时」合辑——从第一个 ADK Agent 到长跑与多 Agent
本文是对 @lesliedqbb 挂载的一段约 72.2 分钟横屏视频的摘要与评论。读帖时约 4600 曝光、约 102 赞、85 收藏、19 转发。帖文钩子写「谷歌工程师刚刚推出……1 小时课程」并给出四段进度条;正片并不是一门从头连录的单课,而是把 Google Cloud Tech 上多段 Agent 内容按主题拼进同一条时间线。插图为关键帧;完整口播请看原帖视频。站内另有一篇更长的 Annie Wang Agent 课解读(约 2.5 小时、偏 harness / Memory Bank / resume),素材与讲者不完全重叠,可对照看。
全文主线可以压成一句:先会搭一个会「推理—行动—观察」的 Agent,再谈记忆分层,再谈跨天长跑,最后才用 description 路由多 Agent 并接上真实网页——顺序反了,多 Agent 只会变成角色扮演。
这篇在说什么
按帖内时间戳,大致四块:
| 进度 | 时间 | 帖文标题 | 片中实际重心 |
|---|---|---|---|
| 0% | 0:00 | 如何构建你的第一个 AI 代理 | Smitha Kolan(Senior AI Engineer)讲 Agent 定义、三种行为模式,并用 ADK 搭「博客规划 / 写作」多 Agent |
| 25% | 8:24 | 构建代理记忆 | 短时记忆 / Sessions & State 等记忆路线图(「3 episode series」) |
| 50% | 28:34 | 代理循环、长期运行 | Addy Osmani(Agent Factory):长跑 Agent——可休眠、可检查点、评价与生成分离 |
| 100% | 1:00:22 | 多代理系统 | 根 Agent 按 description 路由子 Agent;MCP 拉真实网页等生产向模式 |
ADK 是 Agent Development Kit 的缩写,可以白话理解成 Google 侧「做 agent 的开发套件」:提供会话、工具调用、工作流编排等,而不是让你从零手写每一层。帖文末尾「阅读下面文章中如何运行多个代理」在公开帖文里没有挂出独立文章链接;下文按视频本身整理。
先从第一个 Agent 的定义讲起。没有「推理—行动—观察」这条回路,后面的记忆与长跑都无处安放。
1. 第一个 Agent:不是聊天,是「推理—行动—观察」
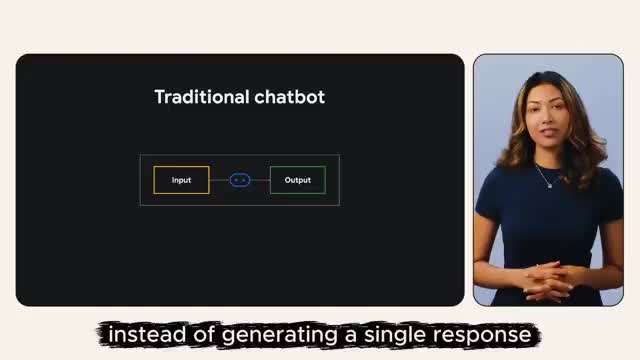
Smitha 开场对比 Traditional chatbot(传统聊天机器人:Input→Output 一次生成)与 Agent:看请求、决定步骤、调 API / 跑代码、看结果、再决定下一步。她引用 ReAct 思路:Reason → Act → Observe → Adjust(推理 → 行动 → 观察 → 调整)。
三种行为模式(片中幻灯 Three agent behavior patterns):
Sequential(顺序式)像流水线,可预期但死板。Reactive(反应式)看当前状态再选工具,灵活但不提前规划。Deliberate / planning(深思/规划式)先画计划再执行——订机票时先确认日期与酒店,而不是随机买票。
跟做例子:用 Google ADK 做博客 Agent——blog planner 产出大纲写进 shared state(用 output_key)→ checker 只回 okay / retry → LoopAgent 最多重试 3 次 → blog writer 同理 → 根 Agent blogger 只暴露 planner / writer 两个工具。环境侧提到 uv、装 ADK、用 adk web 本地 UI。
配套公开材料:Codelab Build an AI Agent with Google ADK(署名 Smitha Kolan)、短片 AI agents explained(约 8 分钟)。
解读:这一段的价值不在「又一个 Hello World」,而在把 LLM Agent + Loop(校验重试)+ 工具化子流程 + 根 Agent 编排 一次讲清——后面记忆 / 长跑 / 多 Agent 都挂在同一套 ADK 心智上。
会跑单任务之后,下一个问题是:跨轮对话还记不记得住?下一节进入记忆。
2. 记忆:先把「这场对话记得住」说清楚
约 8:24 起进入记忆篇,片中明确 Short-term memory = Sessions & State(「Remember this conversation」),并提示这是三集路线图之一。帖文概括为短期 / 持久 / 长期——与 Google ADK 文档里 Session(对话容器)、State(会话键值草稿)、跨会话长期记忆的分层一致。
白话对照:Session 像「这一整通对话的录音带」;State 像「随手写的草稿本」,要代码显式写入才会有值;长期记忆才涉及跨天、跨用户的事实沉淀。
解读:别把「记忆」当成一个向量库口号。短时层解决的是金鱼效应(上一句说了东京美食,下一句又问「你要去哪」);持久与长期才涉及重启、多日工作流——正是下一段长跑 Agent 的前提。若你要更深的 Memory Bank / resume,可看站内 Annie Wang 篇。
记得住,还不等于能跨天干活。下一节 Addy Osmani 把问题从「聊得久」改成「工作流能暂停与恢复」。
3. 长跑 Agent:能睡、能检查点、别自己给自己打分
约 28:34 切入 Addy Osmani(Google Cloud AI,Agent Factory 嘉宾):对比「单次上下文里的演示」与真正的 long-running agent(长跑代理)——工作单元是工作流,不是单次 prompt;状态跨会话保持,跨小时 / 天。
他钉三条。第一,真的能休眠:别用忙轮询烧算力;等 webhook / 定时 / 人审 / 工具回调再醒。第二,每步有检查点:容器挂了也能从耐久状态接着干(例:入职、贷款审批等人填表几天)。第三,别自己评自己:同 Agent 写完再审会系统性高估;倾向 planner / generator / 独立 evaluator 三角。
架构侧口播落到:durable memory schemas、event-driven dormancy gates、multi-agent delegation。
解读:这是整段合辑里工程味最重的一块——把「Agent 能聊很久」纠正成「工作流能跨天、可暂停、可恢复」。和 Annie 课里的定时唤醒 / kill 后 resume 是同一问题族。
单 Agent 长跑之后,才轮到「多个专家怎么协作」。下一节看 description 路由与 MCP。
4. 多 Agent:用 description 路由,用 MCP 碰真实世界
约 1:00 后演示多 Agent 编排(片中电影助手一类例子):根 Agent(Director)读各子 Agent 的 description(职责描述)做意图路由——不是手写 if-else;子角色如评论、推荐、片单管理;评论 Agent 经 MCP(Model Context Protocol,一种让模型按统一协议调用外部工具或数据源的接法)fetch 读 Rotten Tomatoes 页面拿真实评分,而不是写死 API。另有自定义 Python 工具(Pydantic 约束)、session state、安全回调等「生产向」点名。
解读:多 Agent 的难点往往不在「多开几个角色」,而在 路由契约(description)+ 工具边界(MCP / 本地函数)+ 跨轮状态。帖钩子说「1 小时学会多代理」略满;这段更适合当模式速览。
合辑的正确用法是「目录页」:每一段点名一个问题,再跳到对应官方短片或 Codelab 深挖;不要期待七十二分钟里塞进 Annie 长课同级别的 Memory Bank 细节。
Smitha 段最值得留下的心智模型是 LoopAgent 校验重试:生成与检查拆开,比「让同一个角色既写又夸自己」更接近可上线系统。
Addy 段三原则(能睡、能检查点、别自评)可以直接贴进团队设计评审清单;缺任何一条,长跑演示都很难离开笔记本。
多 Agent 段请把 description 当成对外契约来写:写得含糊,路由就会飘;写得过窄,又会把本该协作的任务卡死在单角色里。
为方便未看原片的读者,文中在术语首次出现时会补一句白话解释,并在节与节之间写明承接关系。
写作上刻意避免电报体:不用缺主语缺动词的短句清单冒充正文,而用完整中文句子把因果与限定条件写清。
数字、场次与专有名词以现有文稿与公开来源为准;营销钩子若与正片不符,会单独标明。
本文是摘要与解读,不是逐字稿转载;插图只作关键帧定位,版权归原视频方。
若你读完只能记住一句,请优先记住开篇主线句;其余章节是在为这句话提供证据与边界。
怎么看这条帖
- 优点:一条时间线把「入门 ADK → 记忆分层 → 长跑 → 多 Agent/MCP」串起来,适合当目录页;Smitha / Addy 两段都有可跟做的公开 Codelab / 官方片可回源。
- 水分:营销口径「一门 1 小时课」容易误解为单讲师连录;实际是合辑,片长也约 72 分钟。记忆段在合辑里偏短,深度不如 Annie 长课。
- 和站内已有文:优先补「ADK 博客 Agent + 长跑三原则 + description 路由」;记忆细节去 Annie 篇,避免重复搬运。
补充上下文(第 1 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的提问或场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 2 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的提问或场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 3 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的提问或场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 4 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的提问或场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 5 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的提问或场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
补充上下文(第 6 段):摘要会损失现场语气与停顿;遇到像绝对结论的句子,请回到该节开头的提问或场景里理解。它通常在回答某一类问题,而不是在颁布无条件定律。把场景与结论重新配对,能减少断章取义。
原文
- X 帖(含合辑视频):https://x.com/lesliedqbb/status/2114978265928753278
- Smitha 短片 + Codelab:YouTube · Codelab
- 长跑 Agent(Agent Factory / Addy):https://www.youtube.com/watch?v=VGpfnbr7rso