解读:Anthropic Lydia Hallie 的 Claude Code「会话价值」课——不是 65 Agent Swarm
本文是对 Anthropic 工程师 Lydia Hallie 一场约 27 分钟 Claude Code workshop(幻灯标题 Maximizing the value of Claude Code)的摘要与评论。中文/英文推广帖来自 @res1dualedge(读帖时约 2.5 万曝光、272 收藏、133 赞);同帖还 quote 了 @hanakoxbt 的 QuantGPT「量化研究 agent 团队」长文——本文只解读帖上挂载的这段 workshop 视频。插图为演讲关键帧;完整内容请看原视频。官方同题 essay 亦署名 Lydia Hallie(Claude 博客,2026-08-14)。
读之前先分清对象。Claude Code 是 Anthropic 推出的、跑在终端 / IDE 侧的编程助手:它能读仓库、跑命令、改文件,并按 token(计费用的文本块单位)计费。本课不是教你「怎么开 65 个 Agent 做量化」,而是回答:一次会话的钱花在哪儿、你能拧哪几个旋钮。全文主线可以压成一句:效率不等于少用 token,而是让花出去的 token 对准你真正要它做的事。
这篇在说什么
议程三块——token 怎么被花掉、单会话里你可控什么、给团队配 managed settings(托管设置)/ 观测时有哪些杠杆。口号式结论与上面主线一致。推广帖里的「65+ agents / Chief / PM」在本视频口播与幻灯中均未出现;那是引流钩子,下文「怎么看」会再钉一次。
若你没看过原片,可以把场景想成一场带幻灯的内部培训:讲者面对工程师听众,逐页拆「钱花在哪」;没有量化交易仪表盘,也没有「首席 agent」组织架构图。带着「学 swarm」预期进来的人,需要先换频道。
先把计费单位说清楚
API / Console / 云厂商按百万 token 标价;Pro / Max / Team / Enterprise 则是五小时窗或周窗——但窗本身也是按 token 折算。幻灯把 Haiku / Sonnet / Opus(以及片中口中的 Fable)的 input / cached / output 价并排,提醒:单位始终是 token,换套餐不会换掉这个心智模型。你可以换更贵的座位,但每一次读写仍按字量计。
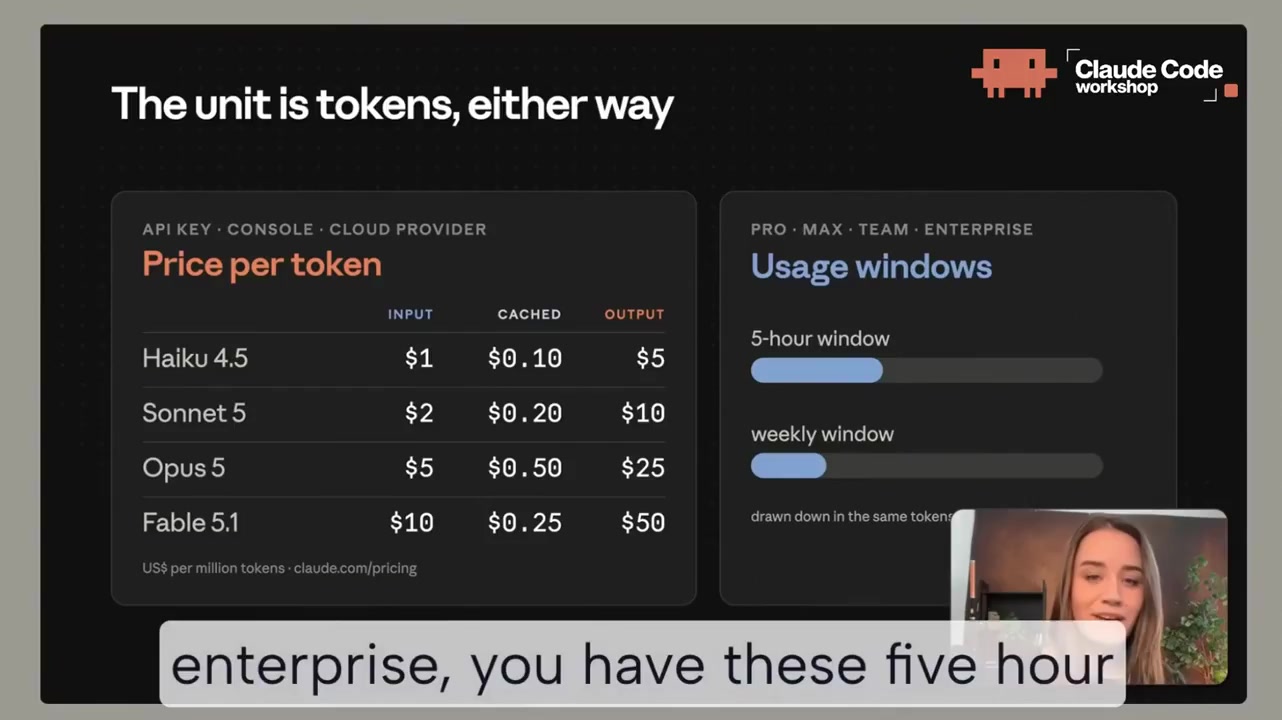
解读:agentic coding 把「付座位」改成了「付每一次工作」;工程习惯第一次直接进账单。以前按月买 IDE 插件,浪费的是时间;现在浪费的是真金白银。
一次请求从来不只是那句 prompt
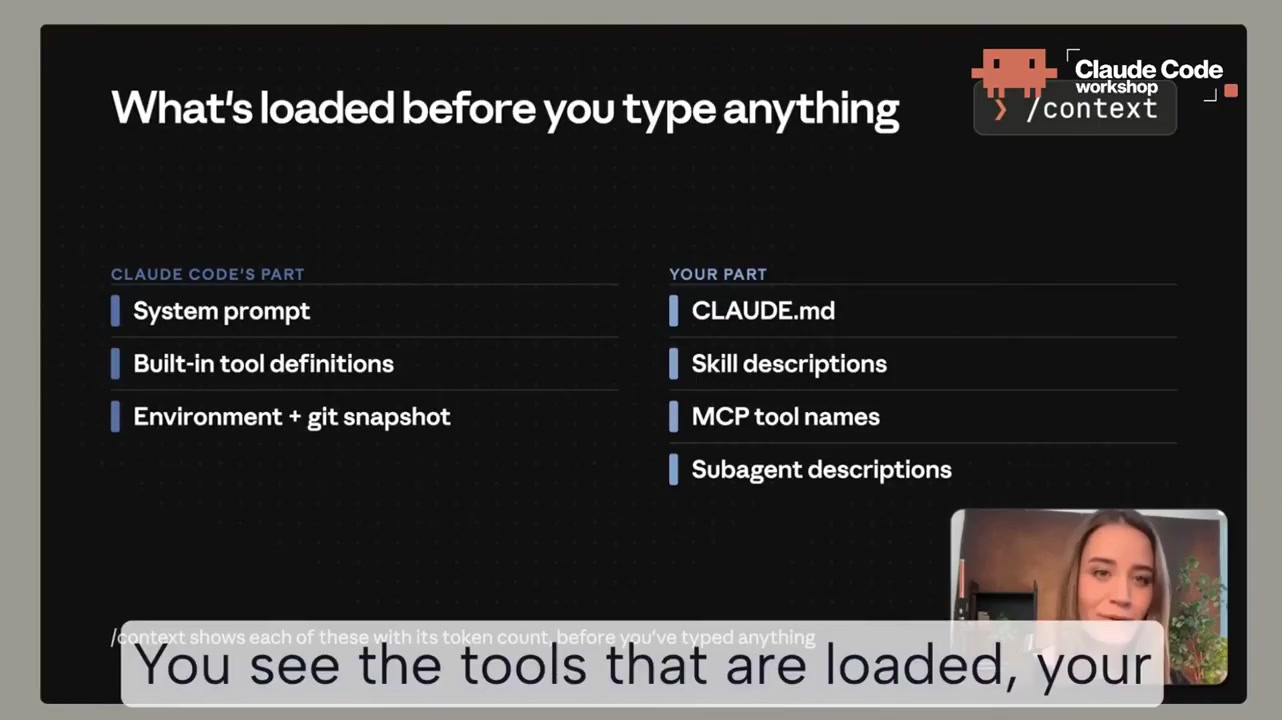
场景要先讲清:你敲 fix the failing test in utils.test.ts 回车时,模型收到的不是这一行字,而是一整包。系统提示与内置工具定义、环境与 git 快照、仓库里的 CLAUDE.md(给 Claude Code 的项目级说明书)、skills(可按需加载的技能说明)与 MCP(按统一协议挂外部工具)的名称与描述,最后才是你那句话。幻灯把前几项标成「会话开始时已加载」,把用户输入标成「我键入的」。
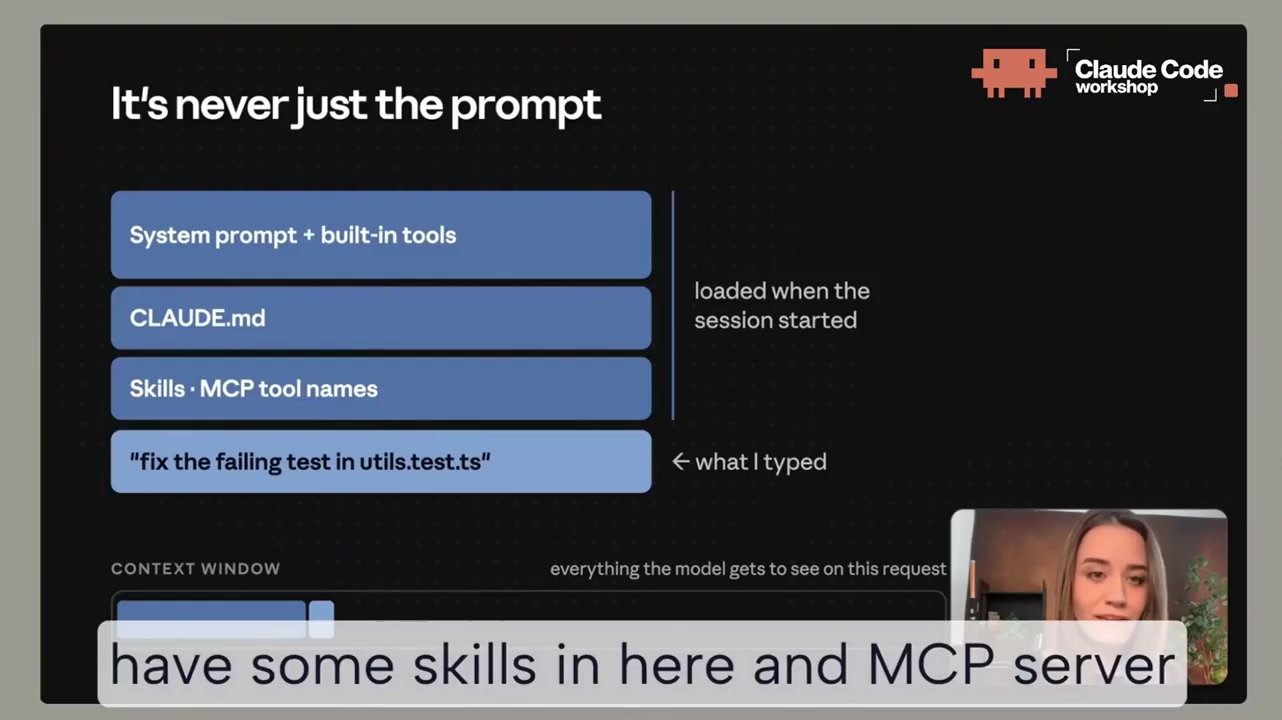
随后是 agent 循环:模型发 tool call(工具调用)→ Claude Code 在本机执行 → 结果再塞回上下文;每一轮往返,上下文条都会变长。你以为在「聊一句」,系统其实在「越聊越胖」。
三类 token:input / output / cached
她把会话画成一条上下文条:蓝是你送进去的(input),橙是模型吐出来的(output,含 tool call、编辑、thinking、最终文字),前缀外包一层 CACHED——与上一请求完全相同的前缀,按缓存价读取。Cached 可以理解成「重复读同一段开头时打折」。
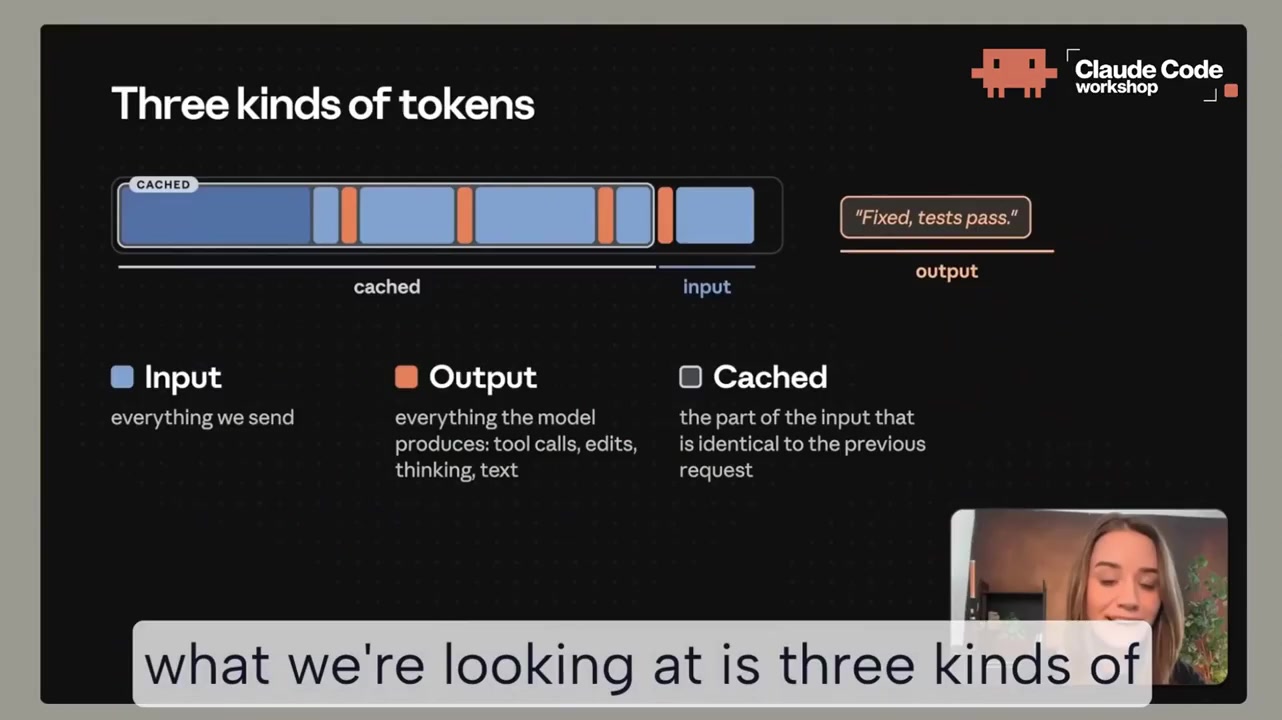
三点很硬核。第一,Input 可批量算,相对便宜。第二,Output 逐 token 生成,每写一个 token 都要对整段上下文再跑一遍,所以最贵。第三,Cached 是健康会话里最大的杠杆:理想状态下大部分 input 应落在 cache;可用会话里的 usage / prompt cache 行自查。换更大模型会乘在所有 token 上——更大等于每 token 更多计算,进出都更贵。
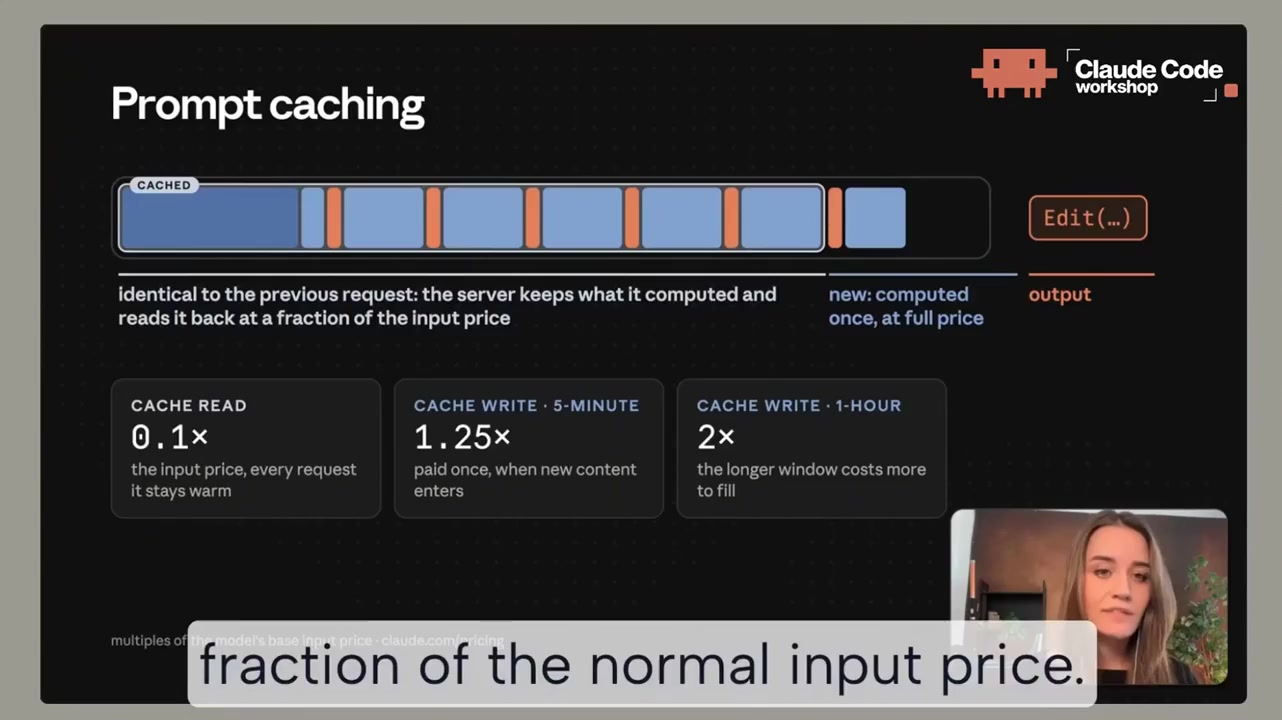
解读:别把「默认 Opus / 最高 effort」当敬业;那是在给每一次机械改动付专家价。小修复用小模型,不是偷懒,是计价纪律。
模型、上下文、CLAUDE.md 与 MCP
她给的分工直觉大致是:机械 / 已在上下文里的小活用小模型;通才用 Sonnet;真正陌生或微妙的 bug 再上 Opus;片中还提到 Fable 一类「更专科」档。上下文侧有几条可执行习惯。
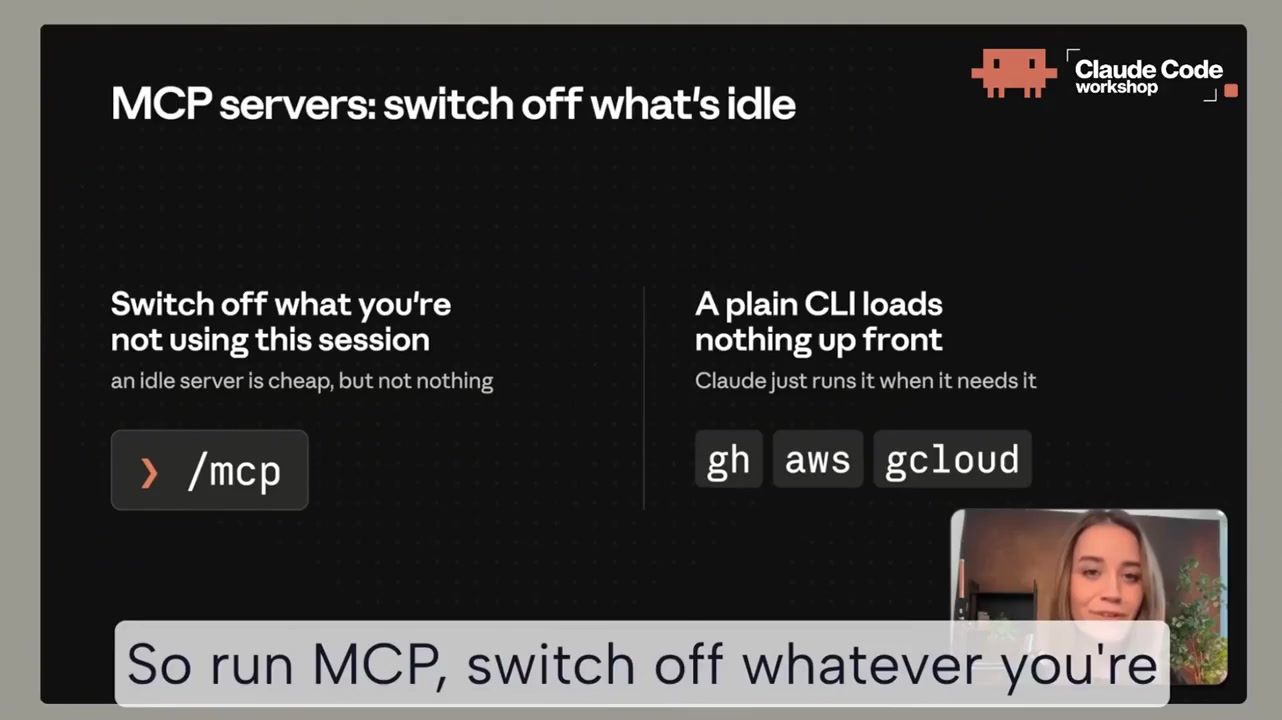
用 @文件 直接挂上内容,少一轮 Read。开新会话前打 /context,看系统提示、工具、CLAUDE.md、skills、MCP 各占多少——先看见胖子在哪,再决定减什么。CLAUDE.md 只放「每个任务都适用」的规则;「做数据库迁移时才需要」的流程应进 skills(默认只注入名与描述,按需加载全文)。闲置 MCP 用 /mcp 关掉——空转不便宜到零;很多场景用 gh / aws / gcloud 这类 plain CLI 即可,用时才跑、不预载工具定义。
命令输出也会永久占上下文:四百个通过测试各打一行,会变成之后每一轮的税。可靠做法是把日常命令写成 quiet reporter(少说话的报告器),写进共享 CLAUDE.md;特别吵的再丢 subagent(子代理:自带小上下文,只把结论送回主会话)。
Effort、会话膨胀与 /compact · /rewind · /clear
Effort(努力程度)告诉模型「宣告完工前要多认真」:结果偏懒 → 加 effort;结果乱挖整个设计系统 → 降 effort。模型只往上下文里加、不主动删,所以「一个长会话扛三个任务」可以轻易比「每任务 /clear」贵一截。
三件卫生工具可以记成表格,但请用完整句子理解它们。/compact 把整段对话换成短摘要(可提示保留重点),用来在离开前「趁热压缩」。/rewind 丢掉末几轮,适合刚走错岔路。/clear 开全新对话;若还想回来,先 /rename 再 clear,之后仍可 resume。
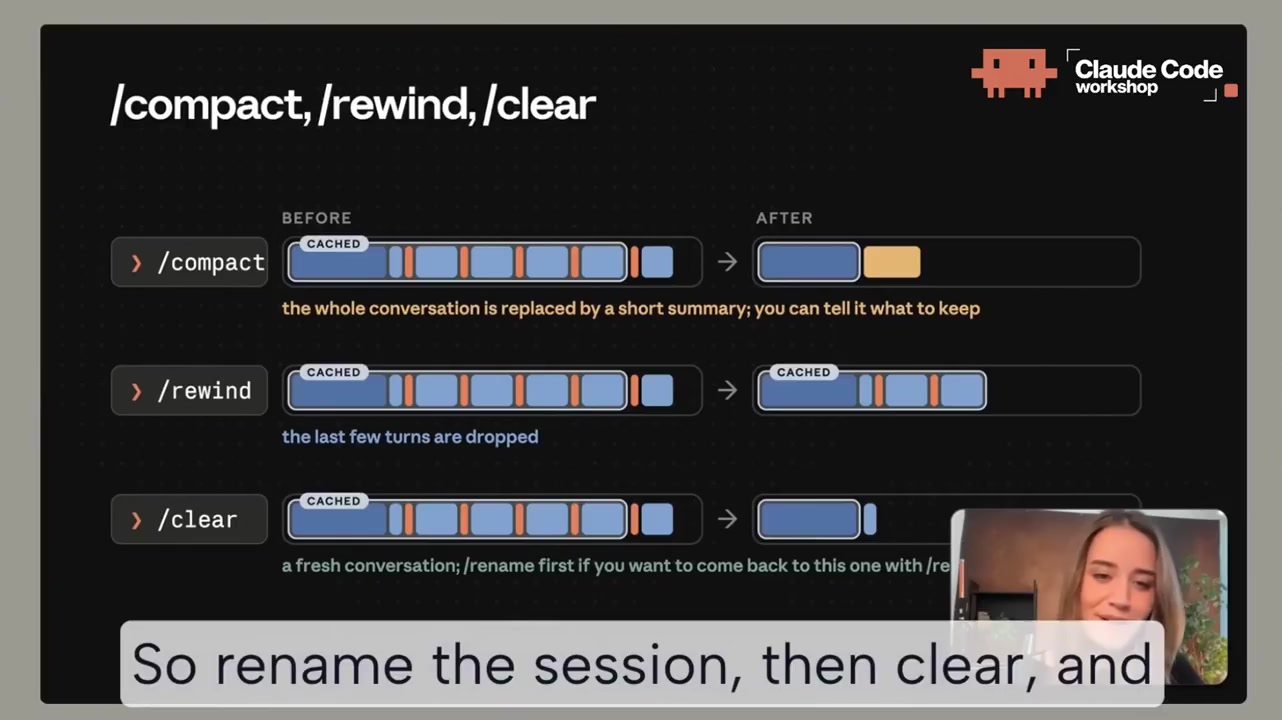
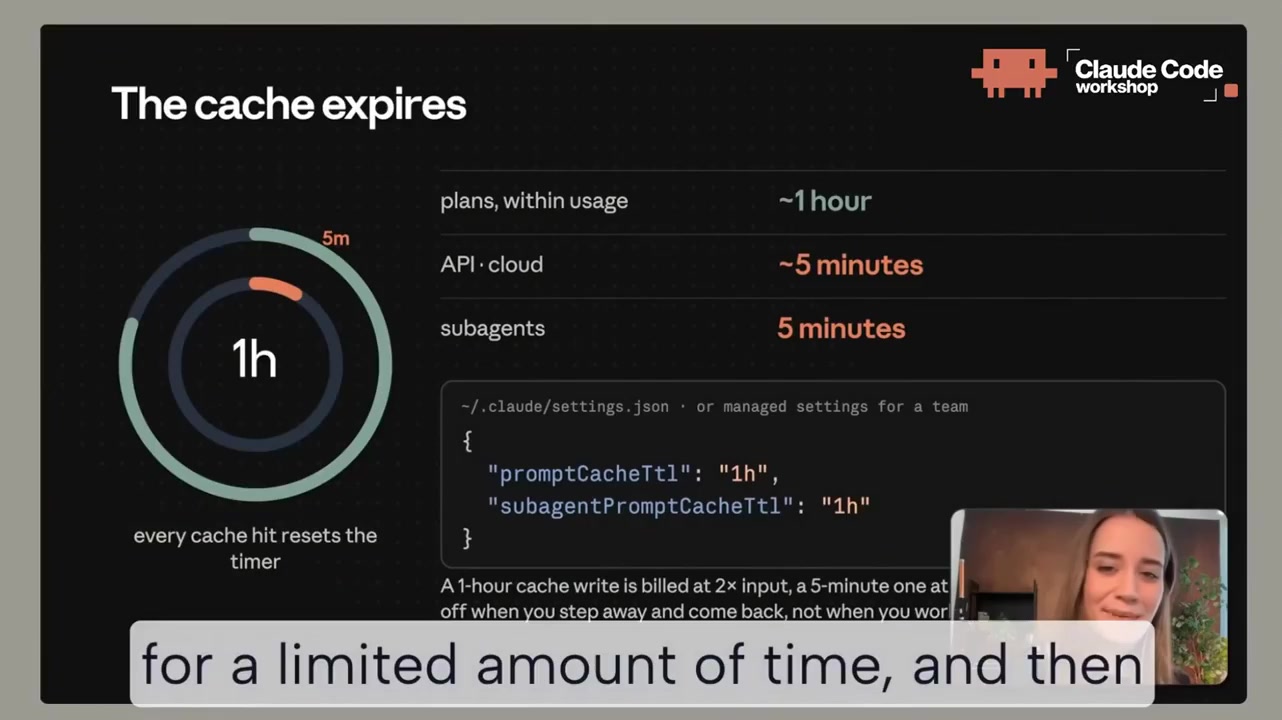
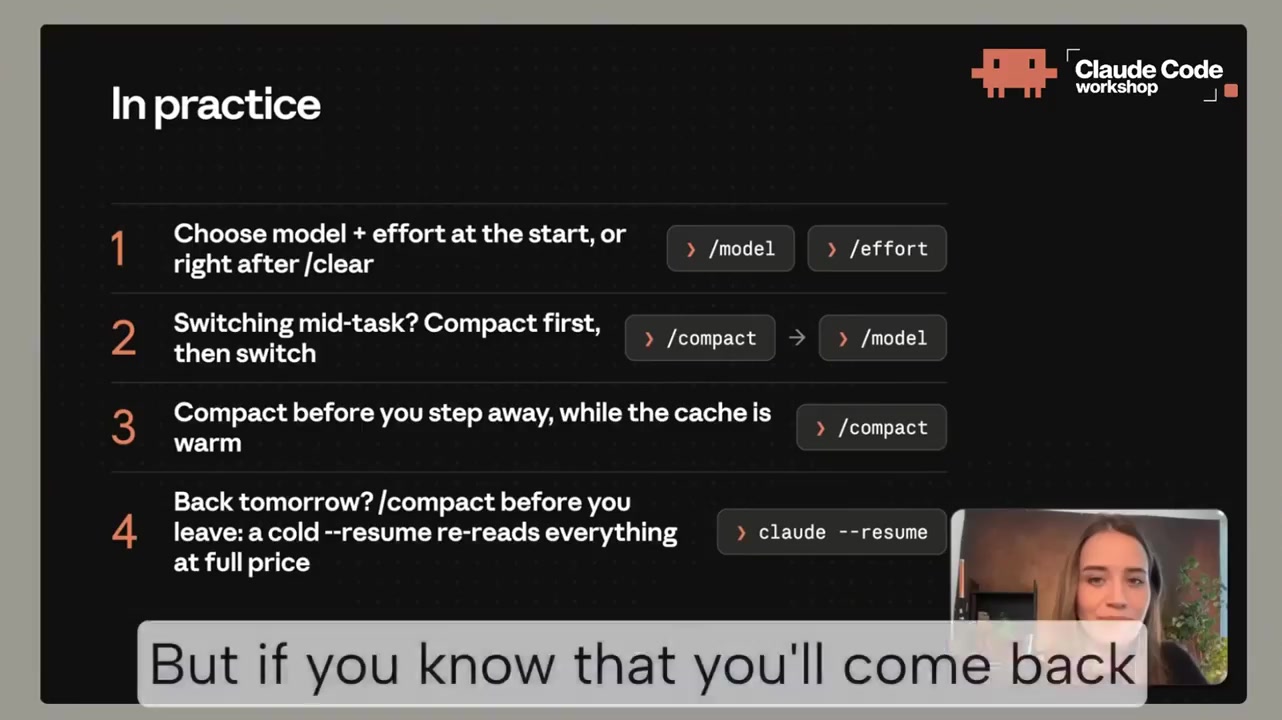
Prompt cache 只能复用「从前缀第一个 token 起完全相同」的部分。因此中途换 model,或(多数模型上)换 effort,会打碎 cache,下一请求整段按全价重读;Fable 5.1 改 effort 是她点名的例外。TTL 方面:订阅计划内工作约 1 小时,API / 云约 5 分钟,subagent 默认 5 分钟(可用配置项调);更长 TTL 写入更贵。实践上:开场或 /clear 后就定 model + effort;中途要换先 compact 再换;离开前趁 cache 还热时 compact——冷启动后再 compact / --resume 等于全价重读。
Subagent 与团队侧杠杆
Subagent 有自己的小上下文:重活(长日志、全仓扫、吵测试)在那边做完,只把结论送回主会话。主会话因此保持瘦、后续每轮更便宜;但 subagent 自身仍计 input/output/cache,不是免费。可为挖矿类 subagent 指定更小模型与 effort。
把它想成「主厨不亲自削整箱土豆」:削皮在后厨完成,主会话只收成品清单。后厨也要付工资,只是不会把土豆皮撒得满桌都是。
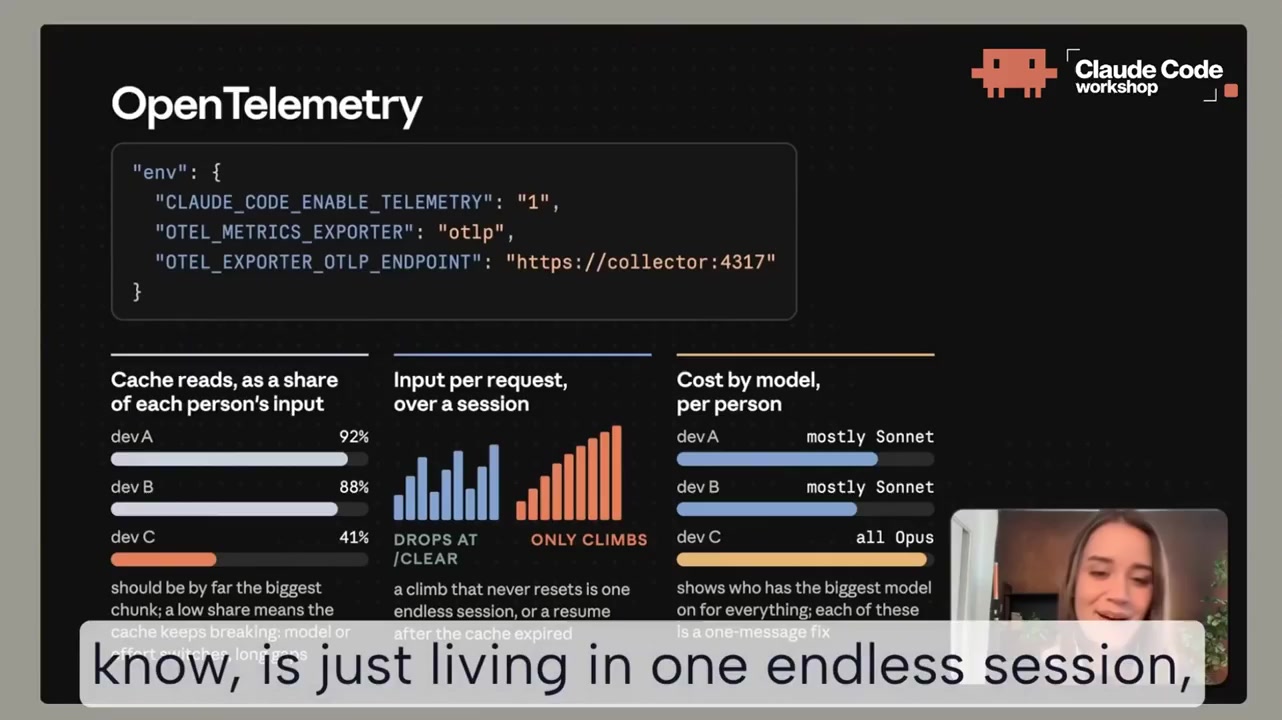
给全队配时,杠杆集中在 managed settings(管理控制台下发、用户不可覆盖):默认 / 允许的模型、默认 effort、enterprise 可封顶、全队 cache TTL、允许的 MCP、组织级 CLAUDE.md。观测侧可开 OpenTelemetry,看每人 cache 读取占比、会话 input 曲线是否在 /clear 处回落、以及「是否有人全程 Opus」。个人省钱靠习惯;团队省钱靠默认值与可见性。
带走的三件事
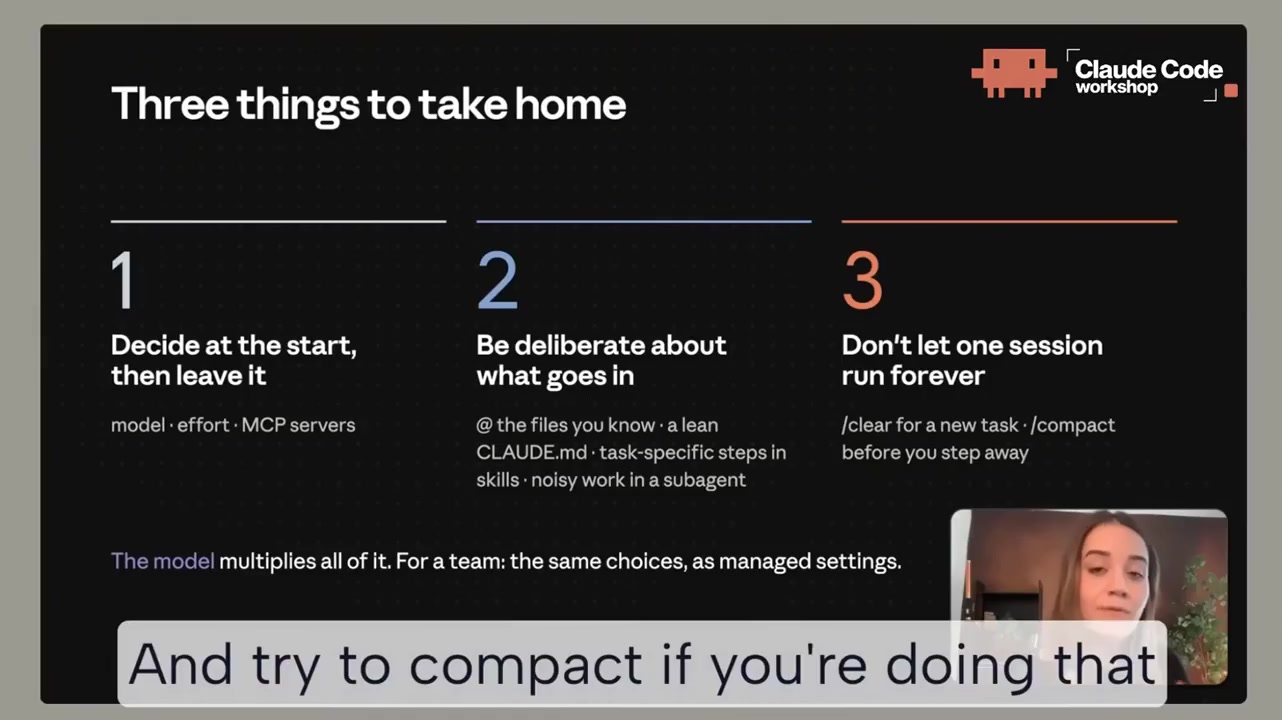
第一,开场定好 model、effort、MCP,然后别乱动,避免无谓破 cache。第二,刻意控制进上下文的东西:@ 已知文件、瘦 CLAUDE.md、任务步骤放 skills、吵活放 subagent。第三,别让一个会话永远跑下去:新任务 /clear;离开前 /compact。模型是乘数;团队把同样选择写进 managed settings。
若你只改一个习惯,优先改这个:新任务先 /clear,离开前先 /compact,开场就定死 model 与 effort。三件事的共同敌人是「会话无限变胖还全程 Opus」。个人项目如此,团队项目更要把同样默认值写进 managed settings,否则省钱只存在于分享会的幻灯片上。
对个人开发者,也可把「团队杠杆」缩成自检:默认模型是不是 Opus?闲置 MCP 关了没有?CLAUDE.md 是否塞进了只在迁移时才用的长流程?三问里有一个答「是」,账单往往已经在泄露。
怎么看这条内容
第一,值什么。把「感觉贵」拆成可操作的机制——三类 token、cache 前缀、effort、会话卫生、团队默认值与 OTel。比再囤一张「省钱 tips」清单耐用:产品会改,机制心智模型还能迁移。
第二,要打折什么。推广帖里的 「99% 把 Opus 当 Google / 1% 跑 self-learning swarm」「我在跑 65+ agents,有 Chief、PM」——在本视频口播与幻灯中均未出现。ASR 全文也搜不到 swarm / 65 / Chief / PM agents。那是引流钩子,不是这场 workshop 的论点。
第三,别和同帖 quote 搅在一起。@hanakoxbt 的 QuantGPT 长文 讲的是「用 Claude Code subagent + 第三方量化 MCP 搭研究团队」——主题、讲者、产品都不同;本片讲的是 Anthropic 官方气质的 token / 会话效率课。把两者焊成「Anthropic 工程师教你 65 agent 量化 swarm」是营销拼接。
第四,和 Boris / poteto 那两篇怎么并列。Boris 侧重「打开 Claude Code 怎么用」的工作流清单;poteto 侧重「如何信任并行 Agent」;本篇补的是 钱与上下文卫生——三篇可以叠,但不要用一篇的钩子冒充另一篇的内容。
可继续阅读原文与完整演示:
- X 原帖与视频(@res1dualedge)
- 讲者:Lydia Hallie(Anthropic);同题 essay 见 Claude 官方博客 Maximizing the value of your Claude Code sessions(2026-08-14)
- 同帖 quote(另文,非本片):How to Build an AI Quant Research Team with Claude Code(@hanakoxbt)
截图仅作解读插图,版权与表述以原演讲为准;本文不做逐字稿转载。ASR 转写仅供整理,专有名词偶有噪声(Claude→cloud、CLAUDE.md→cloud MD、cache→cash 等)。