解读:百度 Unlimited OCR 2——一次请求「不限视距」解析长文档
本文是对开源项目 baidu/Unlimited-OCR 的摘要与评论。当前默认分支 main 推送的是 Unlimited OCR 2,由百度 / Baidu ERNIE Team 维护。抓取时仓库约 ★30288、forks≈3228、watchers/subscribers≈165、open issues≈93;语言以 Python 为主,许可证为 MIT。仓库约于 2026-06-18 创建,页面更新至约 2026-11-02,最近一次 push 约在 2026-10-29。第一版代码仍保留在分支 UnlimitedOCR1.0。文中插图取自仓库 assets/(架构图、榜单图,以及哈利·波特全书 one-shot 解析的可视化);安装步骤、服务参数与完整评测流程,请以仓库 README 与论文原文为准。
说明:下文涉及的加速比、榜单 Overall、显存数字等,均转述自官方 README、仓库 PDF《Unlimited OCR Works 2》与 arXiv 摘要,并非本站实测。选型与复现前,请以仓库、论文 PDF 以及 arXiv:2606.23050 为最终依据。
全文主线可以压成一句:把「抄一整本书」这件事,从「上下文随页数一起爆炸」改成「每一步只盯着固定大小的工作参照」——作者称之为从长文档 OCR 迈向 OCR-3.0 的 Unlimited-Horizon(不限视距)一次请求解析。
这篇在说什么(以及和常见 OCR 路线差在哪)
站上暂无专门重复的 OCR 专题文;先用一张对照表把位置说清楚,再展开场景。
| 常见路线 | 差在哪 |
|---|---|
| 传统 / 常见单页 OCR 管线 | 一页一页认字;跨页表格、脚注续写、阅读顺序要靠后处理拼回全书 |
| DeepSeek-OCR 一类端到端长文 OCR-2.0 | 把整段文档当成视觉-语言模型一次转录,但解码时 KV 与注意力仍随输出和视觉上下文变长而变贵 |
| Unlimited OCR 2(本仓库) | 在 DeepSeek-OCR 系底座上换上稀疏参照注意力,宣称一次请求可扛到百页级,且逐步解码开销近乎与文档长度无关 |
先讲场景,再讲名词。假设你手头有一本扫描版手册、一份上百页的合同 PDF,或一套要进检索 / RAG 的历史文档:旧做法通常是切页 → 每页做 OCR → 自己拼阅读顺序与跨页表格。DeepSeek-OCR 等所谓「OCR-2.0」把整本当成一次视觉-语言模型(Vision-Language Model,即以图像为输入、用语言模型写出文本)的转录任务,从而减少了多级管线的误差累积。可一旦文档拉长到几十、上百页,每一步解码都要和越来越多的视觉 token 交互,显存与延迟就会跟着页数往上爬。作者把人类抄书的直觉写进了模型:抄当前页时,眼睛主要盯着这一页,偶尔才瞟一眼前后相关处——而不是把整本书的像素一直挂在「工作记忆」里。
Unlimited OCR 2 的口号是:Pioneering the OCR-3.0 Era: From Long- to Unlimited-Horizon Parsing——也就是从「能处理很长」推进到「视距名义上不设上限」的一次请求解析。权重与试用入口包括 Hugging Face 上的 baidu/Unlimited-OCR-2、ModelScope 上的 PaddlePaddle/Unlimited-OCR-2、Hugging Face Space 演示,以及百度云文档页。
1. 痛点:长文档 OCR 卡在「工作记忆」,而不只是「认不认识字」
单页识别上,现有的端到端模型已经相当能打;真正拖垮工程的,往往是下面几件事。
第一是跨页结构:表格跨页、段落被页脚切开、标题层级需要在全书尺度上保持一致——这些都不是「单页认字准不准」能单独解决的。
第二是二次方注意力与 KV 缓存(KV cache:生成时为加速解码而缓存的键值状态,会随序列变长而膨胀)。输出越长、视觉上下文越大,每一步生成就越慢、越吃显存——这和人抄书时「效率不会随页数线性崩掉」形成鲜明对比。论文第一版的 arXiv 摘要把问题说得很直:用大语言模型当解码器可以借到语言先验,但输出一长,KV cache 就会把内存与速度一起拖垮。
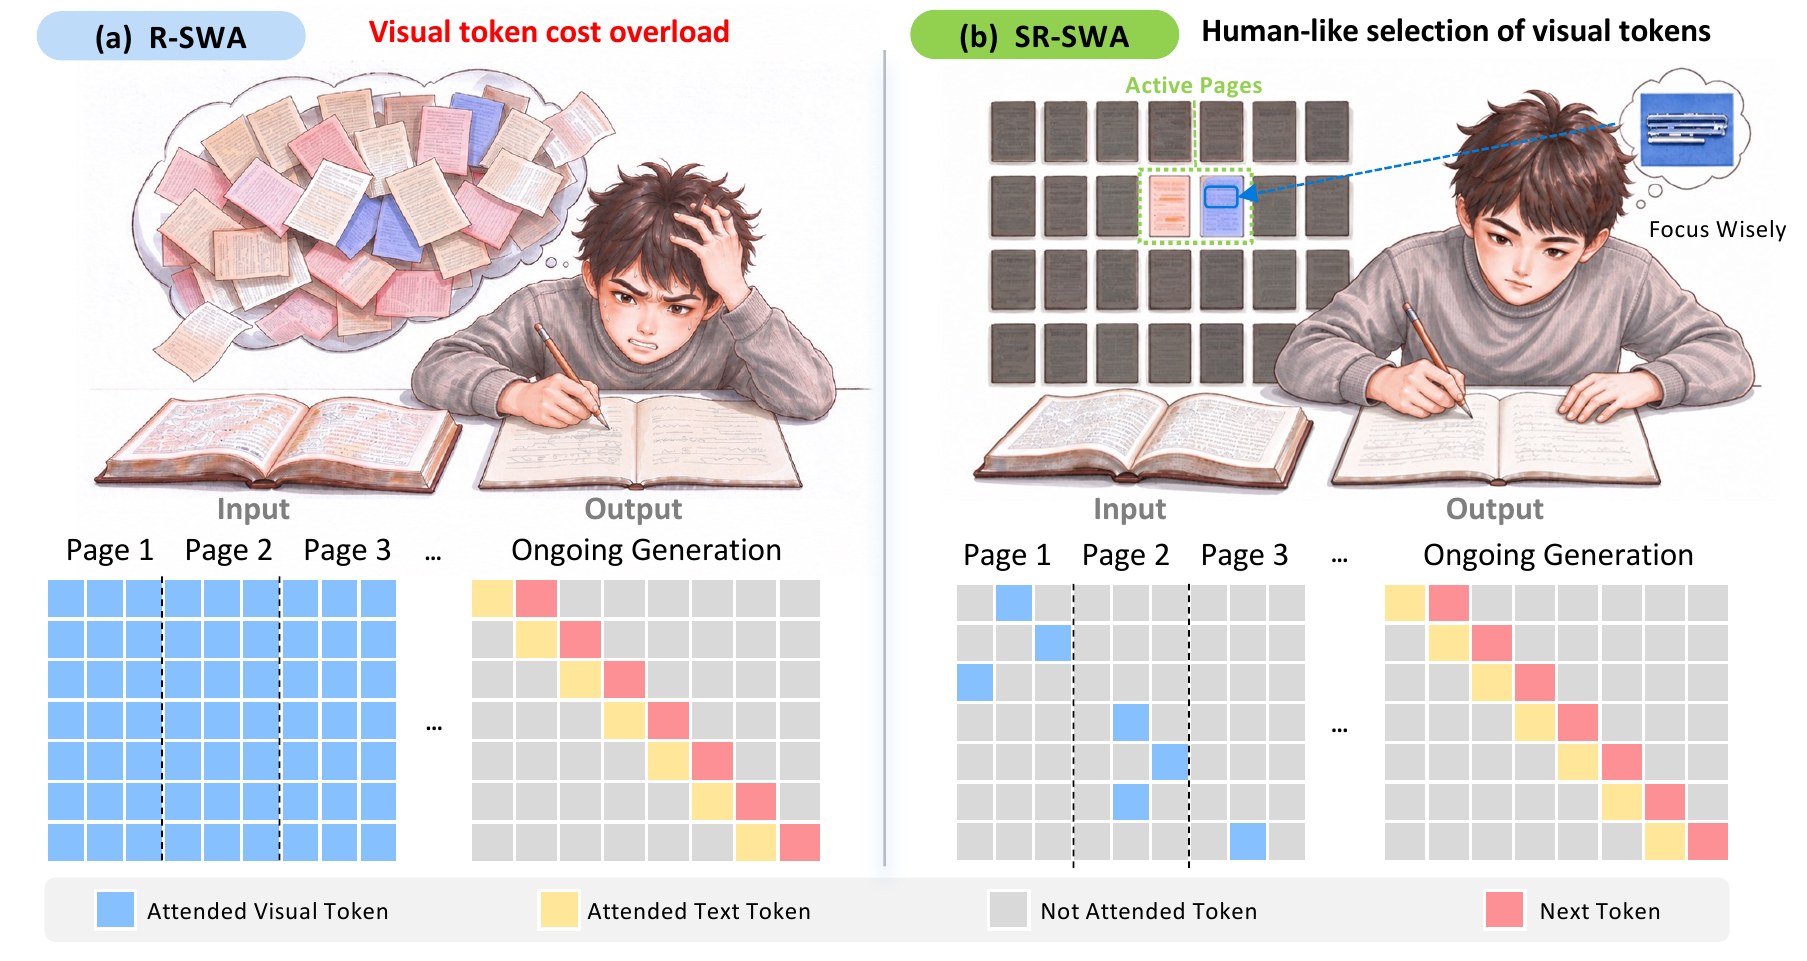
第三是「能跑几十页」仍然不够。第一版的 R-SWA(Reference Sliding Window Attention,参照滑动窗口注意力)已经把文本侧的 KV 约束住了,但解码时仍要对所有页的视觉 token 做注意力;页数上到百级时,视觉侧的冗余本身就变成新瓶颈。这正是 2.0 要动刀的地方。
解读:如果把卖点听成「又一个更准的认字模型」,很容易买错票。它更像在回答另一个问题:端到端解析能不能在百页尺度上既保住结构,又让每步延迟与显存几乎不随页数爆炸。
2. 新在哪:SR-SWA 与「不限视距」解码
OCR-3.0 / Unlimited-Horizon(白话)
作者把时代叙事分成三档(以仓库与 2.0 PDF 为准):
- OCR-1.0:检测加识别等多级管线,页与页之间靠后处理拼接。
- OCR-2.0:端到端视觉-语言模型转录,DeepSeek-OCR 等是代表。
- OCR-3.0(作者口径):在有限的上下文窗口里,对「几乎任意长度」的文档做**不间断、一次请求(one-shot)**解析——也就是他们所说的 Unlimited-Horizon Parsing(不限视距解析)。
「不限视距」并不是魔法无限显存,而是:通过稀疏参照,再配合分窗与复用 KV 等工程范式,让有效工作集保持有界,从而在工程上逼近「页数再长也能继续抄」。
SR-SWA:Sparse Reference Sliding Window Attention
仓库 README 的核心句,可以这样用白话重述:
稀疏参照滑动窗口注意力(SR-SWA,Sparse Reference Sliding Window Attention) 把超长序列上的图文注意力交互,压缩到一组固定大小的 working references(工作参照)——README 举例约 512 tokens——从而把计算复杂度框住,使每步解码延迟与显存足迹几乎不随文档长度变化。
2.0 技术报告(仓库内 PDF)与 arXiv 第一版摘要的对应关系要分清,避免把两版机制混读:
| 版本 | 注意力机制 | 要点(作者表述) |
|---|---|---|
| Unlimited OCR(v1,arXiv:2606.23050) | R-SWA | 替换解码器注意力,全程近似常数 KV;宣称在约 32K 最大长度下,一次前向可转录数十页 |
| Unlimited OCR 2(2026-10-27 起进入 main) | SR-SWA | 在 R-SWA 之上再稀疏化视觉参照:先用 Page Gate(页门控,把注意力收窄到相关页),再用 Token Sieve(token 筛,按预算选出 top-𝑘 远程块),最终构造定长的工作参照视觉 token 集 |
PDF 摘要还给出了效率侧的作者数字(百页尺度、逐步速度):相对 Full Attention 约 7.0×、相对 R-SWA 约 5.6× 的逐步加速——仍属论文宣称,不是本站复现。
架构底座方面(据 PDF),2.0 继承了 Unlimited OCR / DeepSeek-OCR 路线:DeepEncoder 加上 MoE 解码器(文中称总参约 3B、每 token 激活约 500M),再把解码注意力统一换成 SR-SWA。
致谢里点名了 DeepSeek-OCR / OCR-2、PaddleOCR,以及服务框架 SGLang。
解读:从 R-SWA 走到 SR-SWA,本质是承认「文本侧 KV 恒定还不够」——百页时,视觉 token 全集才是新的二次方税。SR-SWA 用「先选页、再筛块」去模仿抄书时的局部注视;它是否总能选对跨页依赖,要靠 MarathonDocBench 这类强调跨页结构的基准来压测,而不能只看单页 Edit Distance。
新基准:MarathonDocBench
配套发布的 Hugging Face: baidu/MarathonDocBench(与 README 同日发布口径)面向百页级文档解析。按 PDF 描述,数据集约有 100 篇文档,每篇约 103–300 页,约 205k 个标注版面元素;相对原先数十页量级的 MPDocBench,它在文档长度与跨页文本 / 表格密度上都明显加码。标注包含框、块类型、层级、阅读顺序、跨页续写等,并经过人工与视觉-语言模型迭代校对——细节以数据集卡与论文为准。
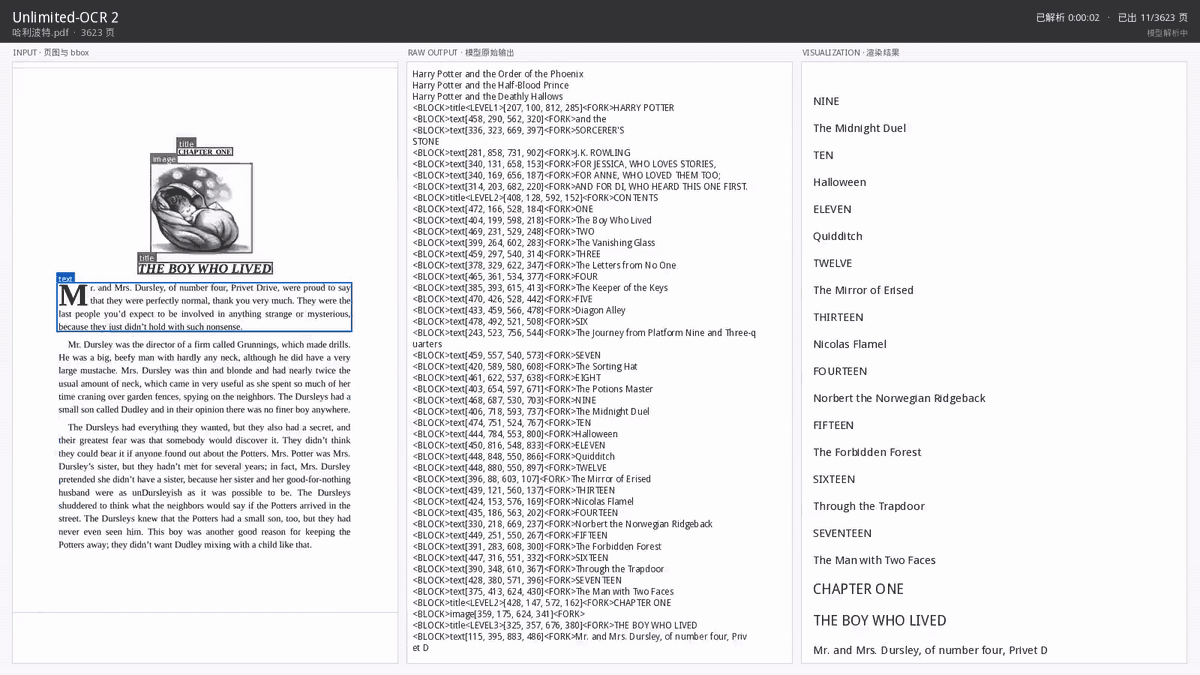
可视化上,仓库用整本《哈利·波特》一类长书的 one-shot 解析回放 GIF(assets/HarryPotter.gif)来演示「不限视距」;本稿附官方首帧与压缩预览,完整大 GIF 仍以仓库为准。
3. 怎么跑(门槛先说清楚)
运行门槛(务必先读):官方 Transformers 示例测在 NVIDIA A800-80GB 上;生产路径推荐安装 README 给出的定制 SGLang wheel(具体文件名形如
sglang-0.5.20.dev13+...whl),并不是随手执行pip install sglang就能对齐论文里的服务形态。如果没有大显存 GPU,或不想跟定制推理栈打交道,更适合先玩 Hugging Face Space 或百度云文档页,而不是把它当成「笔记本上五分钟可复现的 demo」。
Transformers(原生路径,适合快速试)
README 给出的环境口径是:Python 3.10,torch==2.13.0,transformers==4.52.1 等(以 README 钉死的版本为准)。
infer:面向单页;默认使用 gundam 动态切块(tiling,即把一页切成多块再编码,偏细粒度)。infer_multi:面向多页一次请求;按页序传入图片列表,prompt 形如"<PAGE><image>" * num_pages + "Multi page parsing.",便于吃到跨页上下文。多页场景下,每页常以 base 全局视图编码。
# 示意:多页一次请求(细节以 README 为准)
pages = [f"your_doc/page_{i}.jpg" for i in range(1, 8)]
text, num_tokens = model.infer_multi(
    tokenizer, image_files=pages, output_path="output/multi", save_results=True
)
SGLang(README 推荐的生产 / 评测路径)
这条路径需要安装仓库提供的定制 wheel,并用 PyMuPDF 等工具把 PDF 转成图片。启动前有一组环境变量,用来控制「文档窗」与显存尖峰;其中 README 原文写了:
export SGLANG_UOCR_EANABLE_DOC_LIMIT=1   # 1=启用文档窗;0=整本一个窗
# 注意:EANABLE 按 README 拼写抄录;疑似 ENABLE 的笔误,改名前先对照当前仓库脚本/issue
export SGLANG_UOCR_DOC_GUNDAM_PAGE_WINDOW=10
export SGLANG_UOCR_DOC_BASE_PAGE_WINDOW=10
export SGLANG_UOCR_MAX_PAGE_TOKENS=20000
export SGLANG_OPT_UOCR_SAM_REL_POS_BIAS_MB=64   # README:默认 512 可能单块 ~462MiB 致 OOM
# …另有 SHM wrap、VLM cache、PYTORCH_CUDA_ALLOC_CONF 等,见 README
用白话把要点说清楚:
- 文档窗 + KV 尾复用:超长书可以按页窗调度,并复用上一窗 KV 的尾部,从而降低峰值显存。窗越小越省显存,但跨窗边界处的上下文合并也会变弱。
SGLANG_UOCR_EANABLE_DOC_LIMIT:本稿按 README 字面抄录,并标注「疑似拼写」;最终以你 clone 到的版本与上游修正为准。- 服务侧还有
--mem-fraction-static、--max-prefill-tokens、CUDA graph 桶与full_prefill_max_req等旋钮。README 写明:并发一高,就容易从 graph 回退到 eager,需要按机器重调。
客户端走 OpenAI 兼容的 /v1/chat/completions,支持 stream;评测脚本 infer.py 配合 utils/process_unlimitedOCR2.py,可以把原始输出收成评测用的 Markdown。
训练侧,Release 笔记感谢 ms-swift 已支持 Unlimited OCR 2 的训练(2026-10-28 口径)。
解读:这是「研究代码 + 定制推理栈」的组合,不是 pip install 五分钟就能变成业务 API 的东西。把定制 SGLang、A800 级显存,以及那串 SGLANG_UOCR_* 变量当成真实准入条件,比把 Trendshift 徽章当准入条件更有用。
4. 评测、边界与不要编造的数字
作者宣称的评测设定
- MPDocBench:数十页量级的多页解析,与既有协议对齐,报告 Edit Distance、TEDS、CDM、F1 等细分项。
- MarathonDocBench:百页级;强调跨页文本与表格。
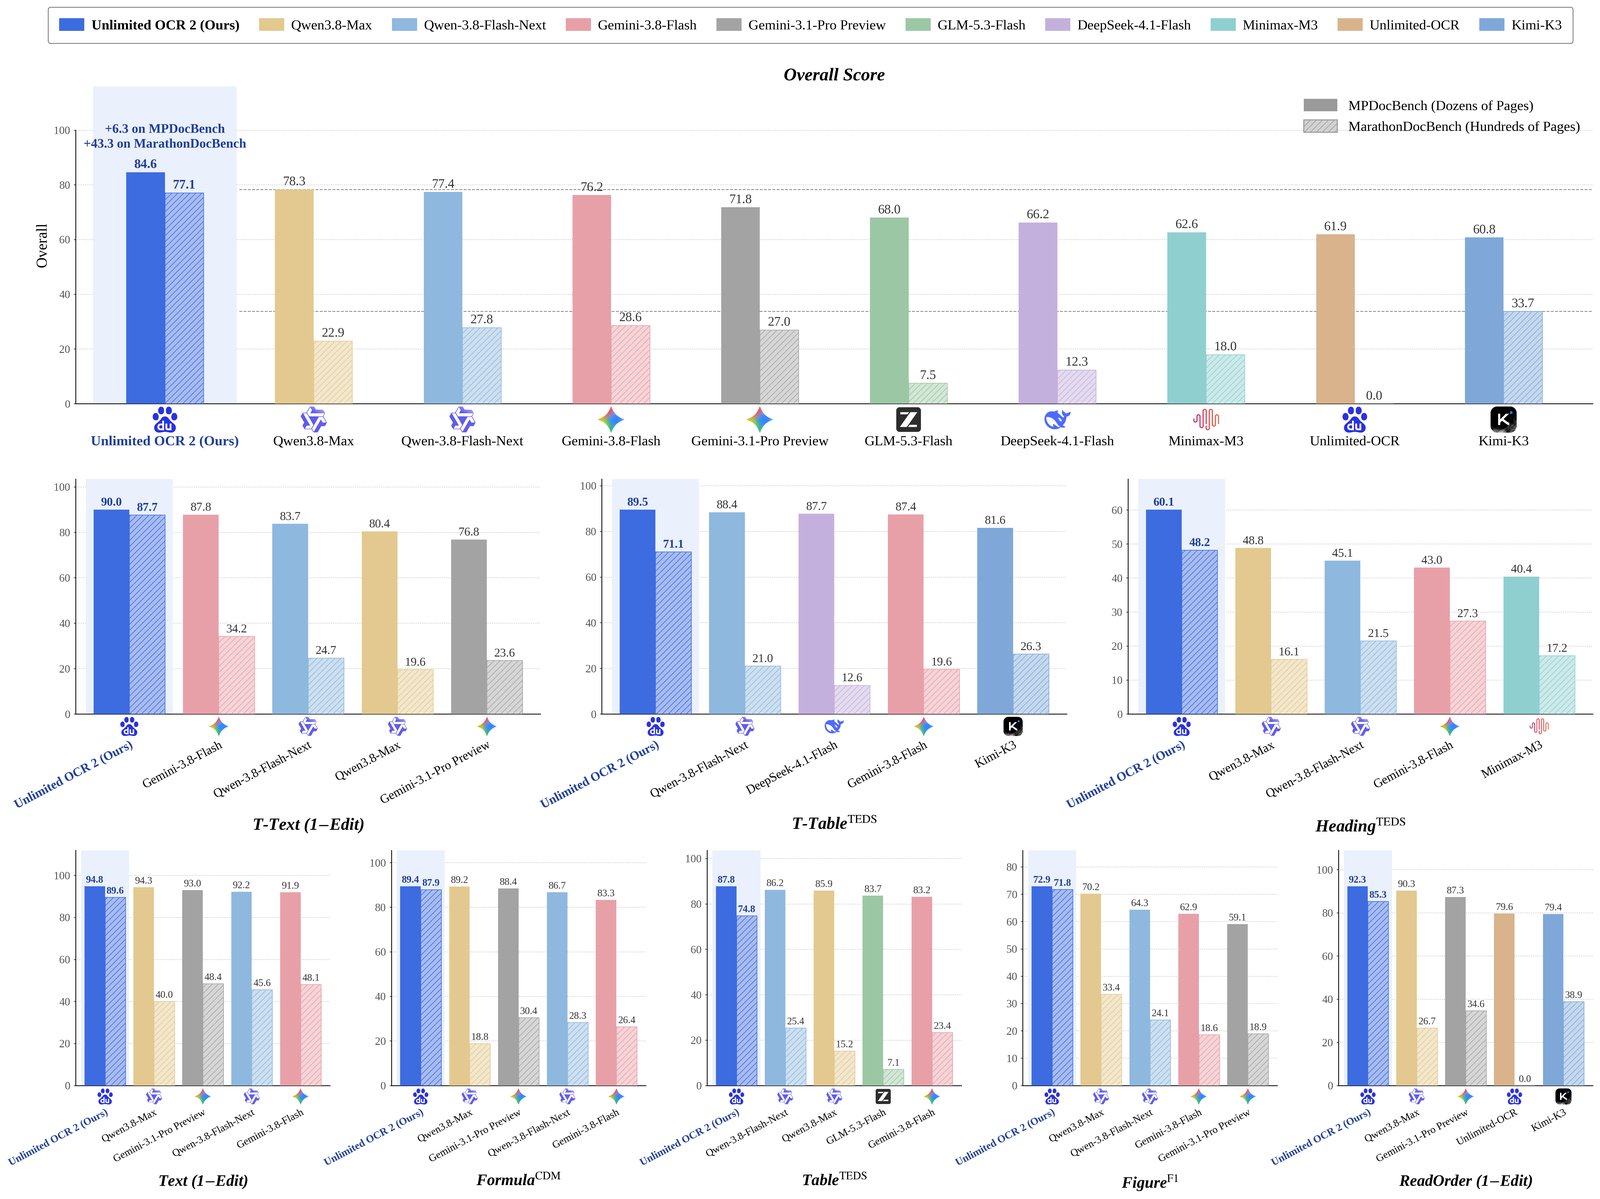
- README 自称 Ultra-Long Document Parsing SOTA(在两类基准上宣称 state-of-the-art)。需要注意:README 正文未列出具体 Overall 分数;细表在仓库 PDF《Unlimited OCR Works 2》里。
论文表格中的作者报告如下(转述,非本站复现;对照模型名以 PDF 原文为准):
- MPDocBench Overall:Unlimited OCR 2 约 84.59(表中 Specialized OCR-3.0 一行)。
- MarathonDocBench Overall:约 77.06;表注写明,第一版 Unlimited-OCR 因约 40 页输入限制未报该榜。
- 单页向的 OmniDocBench:Unlimited OCR 2 Overall 约 94.02,与同表其他专用 OCR 模型同台——作者借此强调,稀疏化之后「局部精细识别没有被牺牲光」。
- 可行性表:标准解码峰值 KV 约 47 GB,Unlimited-Horizon 解码约 1.77 GB(𝐵=1);并发吞吐作者亦给出对照——同样视为论文条件数字。
榜单总览图见仓库 assets/leaderboard.png(本稿转存为较小 JPG):
边界(读 README / PDF 时应自己标红)
- 硬件与栈:需要 NVIDIA 大显存,外加定制 SGLang;Transformers 路径偏试验。
- 「Unlimited」的工程含义:指有界工作参照,加上可选的文档窗,而不是「无限 GPU 内存」的承诺。
- 跨页窗边界:窗切得太碎,跨页合并上下文就会丢——README 自己写了这层 trade-off。
- 版权与内容:演示用《哈利·波特》等长书做可视化,并不代表你可以任意商用受版权保护的全书扫描件;合规是使用方责任。
- 开放 issue 不少(抓取时约 93 个):跟生产前,请扫一遍与显存、wheel、环境变量相关的讨论。
解读:SOTA 叙事在 MarathonDocBench 上最好看——通用大模型在百页端到端结构解析上掉得很厉害(论文图 / 表作者口径),专用稀疏 OCR 则拉回一大截。对外沟通时,建议写成「作者在自建百页榜与 MPDocBench 上宣称 SOTA,详见论文表与仓库图」,而不是口播一个没有出处的百分数。
5. 解读:谁该看、怎么用才不踩坑
对 Vigenz 读者来说,更有用的切法不是「百度又发了个 OCR」,而是下面三条可以带走的判断。
第一,问题定义升级了:讨论焦点从「单页准不准」升到「百页一次请求时,注意力与 KV 如何保持有界」。这和 RAG 里「先切块再嵌入」是不同的产品假设——这里赌的是端到端、带跨页结构的整本解析。
第二,技术上可抄的是机制族,不是仓库名:Page Gate 加 Token Sieve,得到定长的 working references;文档窗加 KV 尾复用,用来压峰值显存。做语音识别、翻译等「长序列抄写」任务时,第一版摘要已声称 R-SWA 类机制可以迁移;2.0 的稀疏视觉路由则更绑在「多页图像」这一设定上。
第三,工程现实要看清楚:定制推理 wheel、环境变量拼写、A800 级实测口径,决定了这是平台 / 研究团队先吃到的红利。业务团队若只是想「把 PDF 变成 Markdown」,应先比较 PaddleOCR 传统栈、云 API,以及 Hugging Face Space 的体验,再决定是否自建 SGLang 服务。
和 DeepSeek-OCR 系的关系,作者自己写在 Acknowledgement 里:站在对方肩膀上再走一步,而不是假装没有谱系。读本仓库时,把 DeepSeek-OCR(底座与问题设定)→ Unlimited OCR / R-SWA(常数文本 KV、数十页)→ Unlimited OCR 2 / SR-SWA(稀疏视觉参照、百页榜) 串成一条线,就不容易被「OCR-3.0」口号带偏。
稳妥的上手顺序可以是:
- 打开 Hugging Face Space,丢一份你自己的十几页扫描件,看跨页表格与阅读顺序是否可用。
- 读 MarathonDocBench 数据集卡与论文 Figure 1 / 3,确认「稀疏参照」是否匹配你的文档类型(纯净书籍 vs 密集跨页财报)。
- 再决定是否投入 A800 级机器与定制 SGLang;评测请用仓库
infer.py链路,避免只看单页 demo 就外推到整本 SLA。
原文与资源
- 仓库:https://github.com/baidu/Unlimited-OCR
- 论文:arXiv:2606.23050《Unlimited OCR Works》;2.0 细节见仓库 Unlimited-OCR-2.pdf
- 模型:Hugging Face
baidu/Unlimited-OCR-2;ModelScopePaddlePaddle/Unlimited-OCR-2 - 基准:MarathonDocBench
- Demo:HF Space Unlimited-OCR-2;百度云文档
- v1 分支:
UnlimitedOCR1.0